Kubernetes:简介与环境安装准备
1、Kubernetes简介
Kubernetes是一个用于容器编排的开源工具,是应用程序级别的虚拟化技术的必然结果。容器化技术运行单个内核上有多个独立的用户空间实例,这些实例就是容器。容器提供了将应用程序的代码、运行时、系统工具、系统库和配置打包到一个实例中的标准方法,并且容器是共享一个内核的。由于容器技术的兴起,导致大量的容器应用出现,所以出现了一些用来支持应用程序容器化部署和组织的容器编排技术,其中Kubernetes现在已经成为了容器编排领域事实上的一个标准。
Kubernetes是一个由Google团队发起的开源项目,旨在管理跨多个主机的容器,用于自动部署、扩展和管理容器化的应用程序。Kubernetes的主要实现语言为Go语言。该项目的理论基础源于Google内部的Borg项目,这使得Kubernetes在理论上比其他开源项目更加先进。Borg系统一直被认为是Google公司内部最强大的“私密武器”,因此Kubernetes的理论基础也非常强大。
架构
Kubernetes 项目依托着 Borg 项目的理论优势,确定了一个如下图所示的全局架构图:
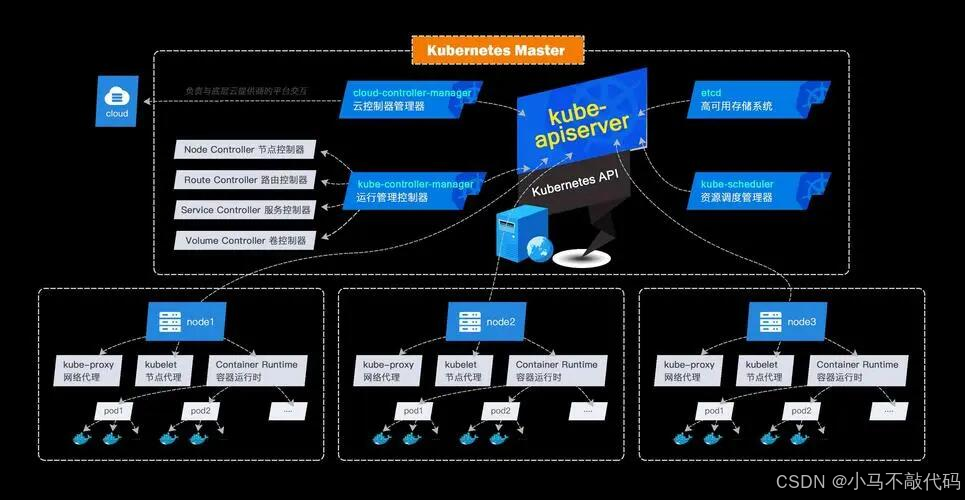
Kubernetes由Master节点和Node节点两种角色组成。Master节点是控制节点,负责管理整个Kubernetes集群的状态和配置信息。Node节点是工作节点,负责运行容器应用。可以将Master节点看作老板,负责管理和控制整个集群的运行状态;将Node节点看作员工,负责实际运行容器应用。这种角色分工使得Kubernetes可以高效地管理和运行容器化应用程序。
Kubernetes的Master节点由三个独立的组件组成,它们分别是kube-apiserver、kube-scheduler和kube-controller-manager。
kube-apiserver是整个集群通信的核心组件,负责接收来自用户和管理员的请求,并将请求转发给其他组件进行处理。
kube-scheduler负责容器的调度,将容器应用程序调度到合适的节点上运行**。
kube-controller-manager则负责维护整个集群的状态,包括容器的运行状态、节点的状态等**。
整个集群的数据都是通过kube-apiserver保存到etcd数据库中的,其他所有组件之间的通信也都是通过kube-apiserver和etcd数据库进行通信,而不会直接与etcd进行通信。这种架构使得Kubernetes具有高可用性和可扩展性,能够满足各种规模的容器化应用程序的需求。
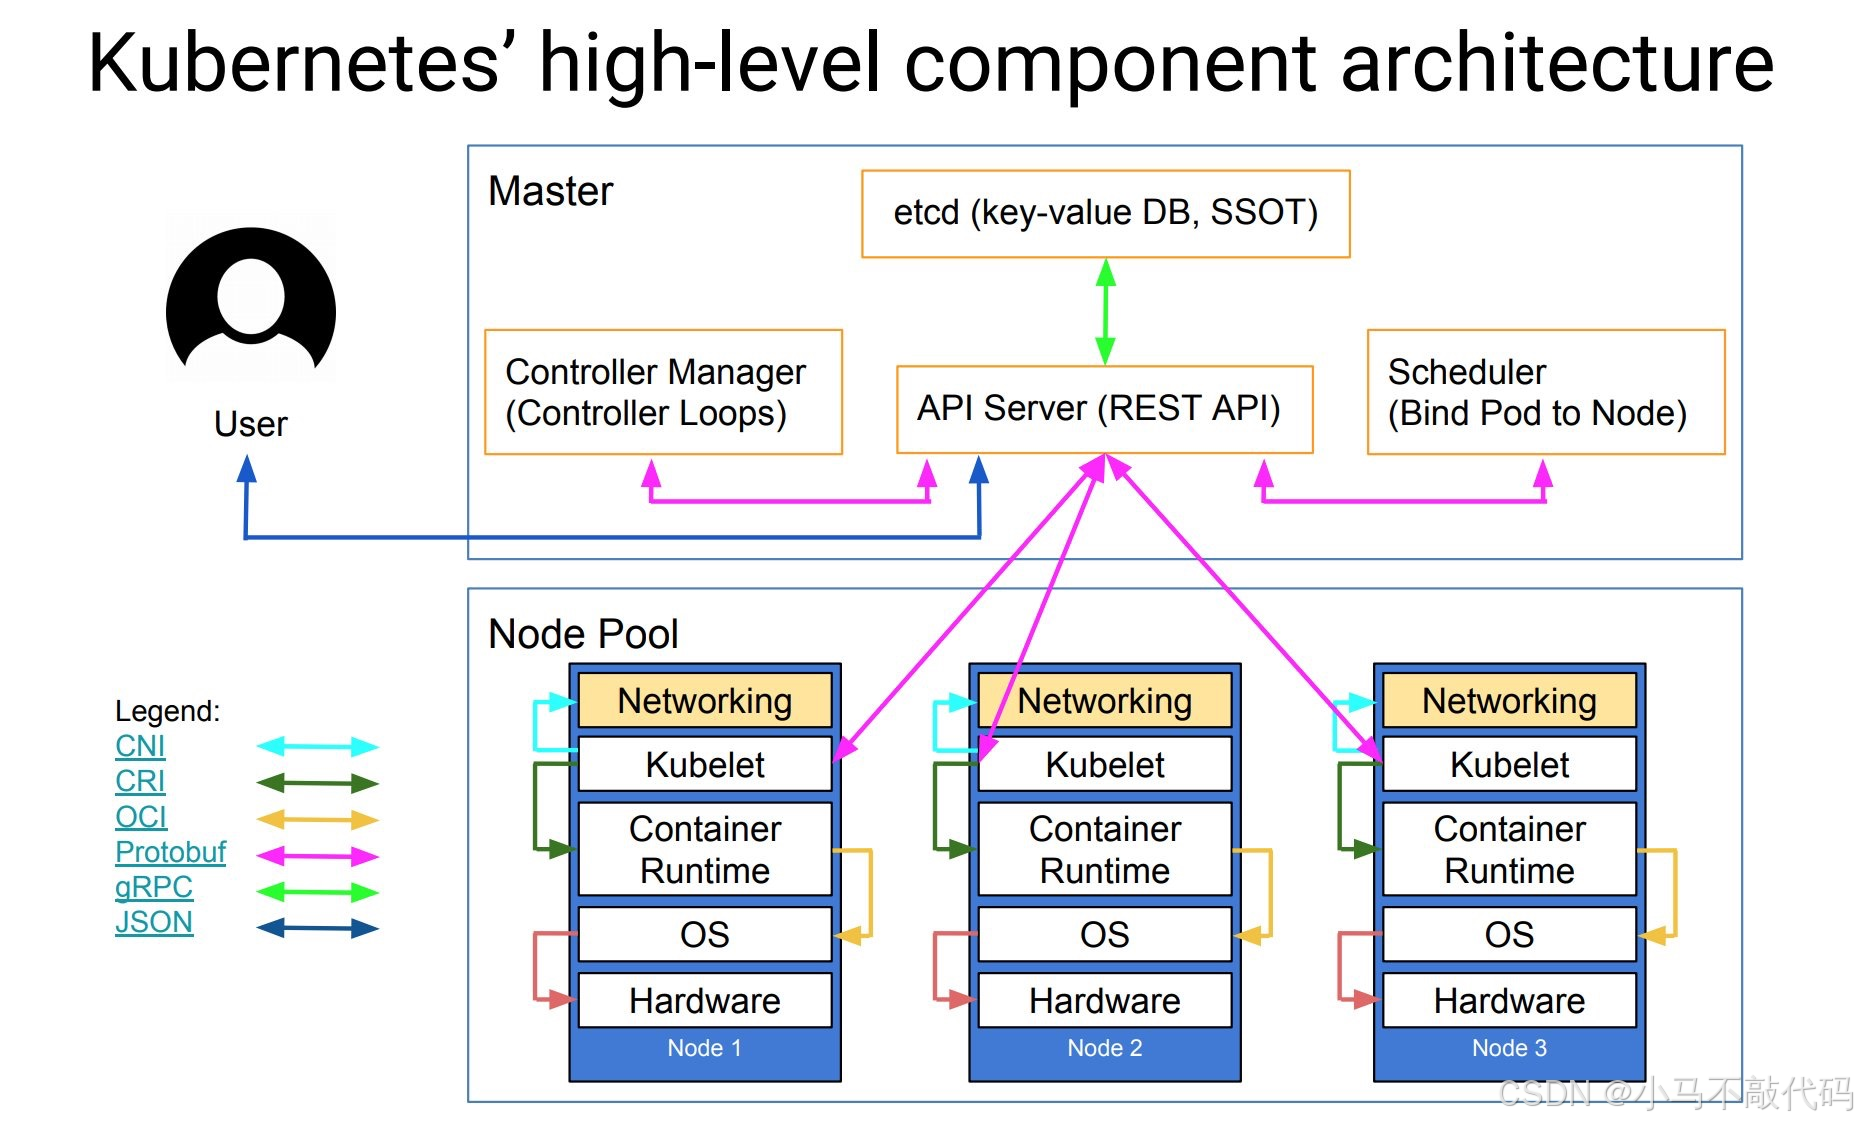
工作节点(Node节点)上最核心的组件是kubelet,它负责与底层的容器运行时进行通信,比如Docker。Kubernetes将这个通信过程抽象成了一个远程调用接口,称为CRI(Container Runtime Interface)。这个接口定义了容器运行时的所有标准操作,例如创建和删除容器。目前,kubelet内置了Docker关于CRI的实现,因此如果底层使用的是Docker容器,则不需要单独安装CRI实现的组件。但是,其他容器运行时需要提供这样的接口实现组件。因此,Kubernetes不关心所部署的容器运行时是什么,只要它能够实现CRI接口,就可以被Kubernetes管理。这种设计使得Kubernetes具有很强的扩展性和灵活性,可以支持多种不同的容器运行时。
kubelet 的另外一个重要功能就是调用网络插件(CNI)和存储插件(CSI)为容器配置网络和存储功能,同样的 kubelet 也是把这两个重要功能通过接口暴露给外部了,所以如果我们想要实现自己的网络插件,只需要使用 CNI 就可以很方便的对接到 Kubernetes 集群当中去。
可能下面的架构图看上去更清晰一些:
2、组件介绍
kube-apiserver
API Server是Kubernetes系统的入口,提供了资源对象的唯一操作入口,其他所有组件都必须通过它提供的API来操作资源数据。只有API Server会与etcd进行通信,而其他模块都必须通过API Server访问集群状态。API Server封装了核心对象的增删改查操作,并以RESTful接口方式提供给外部客户端和内部组件调用。API Server对相关的资源数据进行操作,包括全量查询和变化监听,以实现实时完成相关的业务功能。这种设计使得Kubernetes具有很强的灵活性和可扩展性,同时也使得整个系统更加安全可靠。以 API Server 为 Kubernetes 入口的设计主要有以下好处:
- 保证了集群状态访问的安全
- API Server 隔离了集群状态访问和后端存储实现,这样 API Server 状态访问的方式不会因为后端存储技术 Etcd 的改变而改变,让后端存储方式选择更加灵活,方便了整个架构的扩展
kube-controller-manager
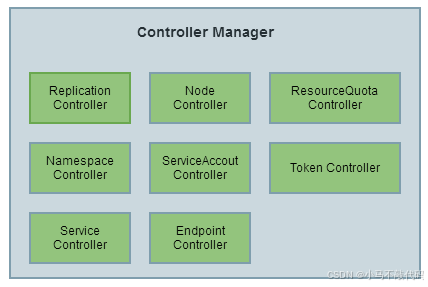
Controller Manager是Kubernetes的一个核心组件,主要用于实现集群故障检测和恢复的自动化工作。
它负责执行各种控制器,包括Node Controller、Replication Controller、DaemonSet Controller等等。
Node Controller负责检测节点的健康状态,如果发现某个节点异常,就会将该节点上的Pod调度到其他正常节点上。
Kubelet 在启动时会通过 API Server 注册自身的节点信息,并定时向 API Server 汇报状态信息。API Server 在接收到信息后将信息更新到 Etcd 中。Node Controller 通过 API Server 实时获取 Node 的相关信息,实现管理和监控集群中的各个 Node 节点的相关控制功能。
Replication Controller负责维护Pod的副本数量,如果发现Pod的副本数量少于期望值,就会自动创建新的Pod。主要是定期关联 Replication Controller (RC) 和 Pod,以保证集群中一个 RC (一种资源对象) 所关联的 Pod 副本数始终保持为与预设值一致
DaemonSet Controller则负责在每个节点上运行一个副本的Pod,确保每个节点都有相应的服务在运行。
Controller Manager通过不断地监控集群状态,并根据预定义的规则执行相应的操作,从而保证集群的高可用性和稳定性。
ResourceQuota Controller:资源配额管理控制器用于确保指定的资源对象在任何时候都不会超量占用系统上物理资源
Namespace Controller:用户通过 API Server 可以创建新的 Namespace 并保存在 Etcd 中,Namespace Controller 定时通过 API Server 读取这些 Namespace 信息来操作 Namespace。比如:Namespace 被 API 标记为优雅删除,则将该 Namespace 状态设置为 Terminating 并保存到 Etcd 中。同时 Namespace Controller 删除该 Namespace 下的 ServiceAccount、Deployment、Pod 等资源对象。
Service Account Controller:服务账号控制器主要在命名空间内管理 ServiceAccount,以保证名为 default 的 ServiceAccount 在每个命名空间中存在。
Token Controller:令牌控制器作为 Controller Manager 的一部分,主要用作:监听 serviceAccount 的创建和删除动作以及监听 secret 的添加、删除动作。
Service Controller:服务控制器主要用作监听 Service 的变化。比如:创建的是一个 LoadBalancer 类型的 Service,Service Controller 则要确保外部的云平台上对该 Service 对应的 LoadBalancer 实例被创建、删除以及相应的路由转发表被更新。
Endpoint Controller:Endpoints 表示了一个 Service 对应的所有 Pod 副本的访问地址,而 Endpoints Controller 是负责生成和维护所有 Endpoints 对象的控制器。Endpoint Controller 负责监听 Service 和对应的 Pod 副本的变化。定期关联 Service 和 Pod (关联信息由 Endpoint 对象维护),以保证 Service 到 Pod 的映射总是最新的。
kube-scheduler
Scheduler 是负责整个集群的资源调度的,主要的职责如下所示:
- 主要用于收集和分析当前 Kubernetes 集群中所有 Node 节点的资源 (包括内存、CPU 等) 负载情况,然后依据资源占用情况分发新建的 Pod 到 Kubernetes 集群中可用的节点
- 实时监测 Kubernetes 集群中未分发和已分发的所有运行的 Pod
- 实时监测 Node 节点信息,由于会频繁查找 Node 节点,所以 Scheduler 同时会缓存一份最新的信息在本地
- 在分发 Pod 到指定的 Node 节点后,会把 Pod 相关的 Binding 信息写回 API Server,以方便其它组件使用
kubelet
kubelet 是负责容器真正运行的核心组件,主要的职责如下所示:
- 负责 Node 节点上 Pod 的创建、修改、监控、删除等全生命周期的管理
- 定时上报本地 Node 的状态信息给 API Server
- kubelet 是 Master 和 Node 之间的桥梁,接收 API Server 分配给它的任务并执行
- kubelet 通过 API Server 间接与 Etcd 集群交互来读取集群配置信息
- kubelet 在 Node 上做的主要工作具体如下:
设置容器的环境变量、给容器绑定 Volume、给容器绑定 Port、根据指定的 Pod 运行一个单一容器、给指定的 Pod 创建 Network 容器
同步 Pod 的状态
在容器中运行命令、杀死容器、删除 Pod 的所有容器
kube-proxy
kube-proxy 是为了解决外部网络能够访问集群中容器提供的应用服务而设计的,Proxy 运行在每个Node 上。
每创建一个 Service,kube-proxy 就会从 API Server 获取 Services 和 Endpoints 的配置信息,然后根据其配置信息在 Node 上启动一个 Proxy 的进程并监听相应的服务端口。
当接收到外部请求时,kube-proxy 会根据 Load Balancer 将请求分发到后端正确的容器处理。
kube-proxy 不但解决了同一宿主机相同服务端口冲突的问题,还提供了 Service 转发服务端口对外提供服务的能力。
kube-proxy 后端使用随机、轮循等负载均衡算法进行调度。
kubectl
Kubectl 是 Kubernetes 的集群管理命令行客户端工具集。通过 Kubectl 命令对 API Server 进行操作,API Server 响应并返回对应的命令结果,从而达到对 Kubernetes 集群的管理。
核心资源对象
上面我们都是在架构层面了解 Kubernetes,但是似乎没有发现关于容器的说明,Kubernetes 作为容器编排引擎,那么他是怎么去对容器进行编排的呢?在 Kubernetes 集群中抽象了很多集群内部的资源对象,我们可以通过这些资源对象去操作容器的编排工作
Pod
Pod 是一组紧密关联的容器集合,它们共享 PID、IPC、Network 和 UTS namespace,是Kubernetes 调度的基本单位。Pod 的设计理念是支持多个容器在一个 Pod 中共享网络和文件系统,可以通过进程间通信和文件共享这种简单高效的方式组合完成服务。我们知道容器本质上就是进程,那么 Pod 实际上就是进程组了,只是这一组进程是作为一个整体来进行调度的。
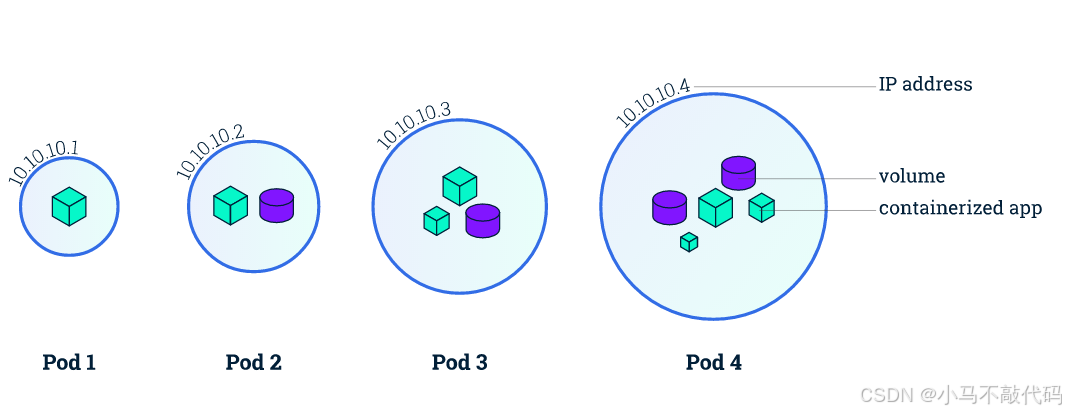
在 Kubernetes 中,所有资源对象都使用资源清单(yaml或json)来定义,比如我们可以定义一个简单的 nginx 服务,它包含一个镜像为 nginx 的容器:(nginx-pod.yaml):
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    app: nginx
spec:
  containers:
  - name: nginx
    image: nginx
    ports:
    - containerPort: 80
定义了这样一个资源清单文件后,我们就可以利用上面我们提到的 Kubectl 工具将这个 Pod 创建到 Kubernetes 集群中:
$kubectlapply-fnginx-pod.yaml
Pod 在 Kubernetes 集群中被创建的基本流程如下所示:
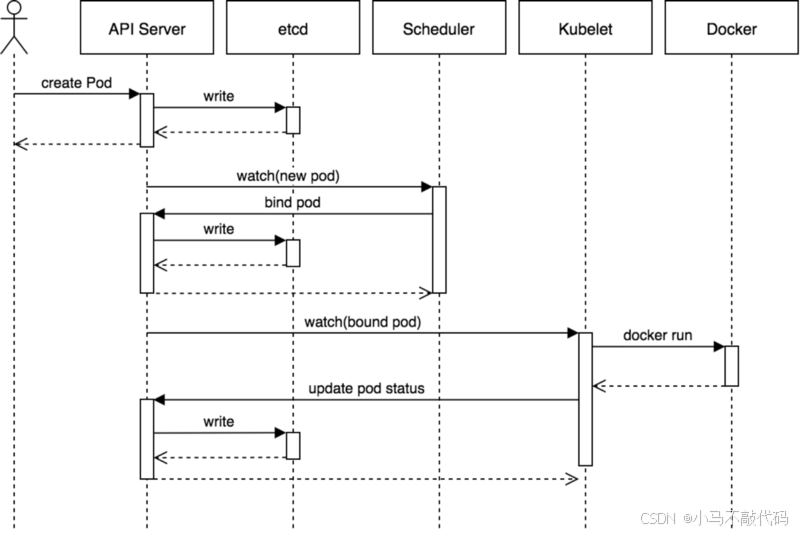
- 用户通过 REST API 创建一个 Pod
- apiserver 将其写入 etcd
- scheduluer 检测到未绑定 Node 的 Pod,开始调度并更新 Pod 的 Node 绑定
- kubelet 检测到有新的 Pod 调度过来,通过 container runtime 运行该 Pod
- kubelet 通过 container runtime 取到 Pod 状态,并更新到 apiserver 中
Label
Label 标签在 Kubernetes 资源对象中使用很多,也是非常重要的一个属性,Label 是识别 Kubernetes 对象的标签,以key/value的方式附加到对象上(key最长不能超过63字节,value 可以为空,也可以是不超过253字节的字符串)上面我们定义的 Nginx 的 Pod 就添加了一个app=nginx的 Label 标签。Label 不提供唯一性,并且实际上经常是很多对象(如Pods)都使用相同的 Label 来标志具体的应用。Label 定义好后其他对象可以使用Label Selector来选择一组相同 Label 的对象(比如 Service 用 Label 来选择一组 Pod)。Label Selector 支持以下几种方式:
- 等式,如app=nginx和env!=production
- 集合,如env in (production, qa)
- 多个 Label(它们之间是AND关系),如app=nginx,env=test
Namespace
Namespace(命名空间)是对一组资源和对象的抽象集合,比如可以用来将系统内部的对象划分为不同的项目组或用户组。常见的 Pods、Services、Deployments 等都是属于某一个 Namespace 的(默认是default),比如上面我们的 Nginx Pod 没有指定 namespace,则默认就在 default 命名空间下面,而 Node, PersistentVolumes 等资源则不属于任何 Namespace,是全局的。
注意它并不是 Linux Namespace,二者没有任何关系,它只是 Kubernetes 划分不同工作空间的一个逻辑单位。
Deployment
我们说了 Pod 是 Kubernetes 集群中的最基本的调度单元,但是如果想要创建同一个容器的多份拷贝,需要一个一个分别创建出来么,那么能否将 Pods 划到一个逻辑组里面呢?Deployment 就是来管理 Pod 的资源对象。
Deployment 确保任意时间都有指定数量的 Pod“副本”在运行。如果为某个 Pod 创建了 Deployment 并且指定3个副本,它会创建3个 Pod,并且持续监控它们。如果某个 Pod 不响应,那么 Deployment 会替换它,始终保持总数为3。
如果之前不响应的 Pod 恢复了,现在就有4个 Pod 了,那么 Deployment 会将其中一个终止保持总数为3。如果在运行中将副本总数改为5,Deployment 会立刻启动2个新 Pod,保证总数为5。持回滚和滚动升级。
当创建 Deployment 时,需要指定两个东西:
- Pod 模板:用来创建 Pod 副本的模板
- Label 标签:Deployment 需要监控的 Pod 的标签。
现在已经创建了 Pod 的一些副本,那么这些副本上如何进行负载呢?如何把这些 Pod 暴露出去呢?这个时候我们就需要用到 Service 这种资源对象了。
Service
Service 是应用服务的抽象,通过 Labels 为应用提供负载均衡和服务发现。匹配 Labels 的 Pod IP 和端口列表组成 Endpoints,由 kube-proxy 负责将服务 IP 负载均衡到这些 Endpoints 上。
每个 Service 都会自动分配一个 cluster IP(仅在集群内部可访问的虚拟地址)和 DNS 名,其他容器可以通过该地址或 DNS 来访问服务,而不需要了解后端容器的运行。
了解了上面的几个基本概念后,我们就完全可以把我们的容器服务迁移到 Kubernetes 集群上了。当然我们还得先搭建好我们的 Kubernetes 集群环境。
3、环境准备
Kubernetes 集群环境安装
为了使用较新的集群特性,我们在这里安装了 Kubernetes 版本 v1.19.3。如果您在生产环境中使用 Kubernetes,我们建议您使用版本中最大的修正版本,例如 v1.19.3。由于 v1.16 版本之后和之前的版本有很大变化,主要体现在 APIVersion 移除了之前的一些版本,因此我们选择了比较新的 v1.19.3 版本。我们主要目的是将项目部署到 Kubernetes 运行并维护,因此我们使用 Kubeadm 来快速搭建单 Master 的集群。在学习一些知识点后,如果需要,我们可以搭建适合生产环境使用的集群。
环境准备
3个节点,都是 Centos 7.6 系统,内核版本:3.10.0-1062.4.1.el7.x86_64,在每个节点上添加 hosts 信息,最终结果如下所示:
[root@node1 ~]# cat /etc/hosts
127.0.0.1   localhost localhost.localdomain localhost4 localhost4.localdomain4
::1         localhost localhost.localdomain localhost6 localhost6.localdomain6
10.10.20.110 master
10.10.20.119 node1
10.10.20.112 node2
节点的 hostname 必须使用标准的 DNS 命名,另外千万不用什么默认的localhost的 hostname,会导致各种错误出现的。在 Kubernetes 项目里,机器的名字以及一切存储在 Etcd 中的 API 对象,都必须使用标准的 DNS 命名(RFC 1123)。可以使用命令hostnamectl set-hostname node1来修改 hostname。
这里我的是将110作为了master主节点 119 112两台服务器作为了node从节点。
设置完hostname之后重新连接ssh就会显示你设置好的master node1 node2的名称了:
禁用防火墙:
systemctlstopfirewalld
systemctldisablefirewalld
禁用SELINUX:
$setenforce0
$cat/etc/selinux/config
SELINUX=disabled
由于开启内核 ipv4 转发需要加载 br_netfilter 模块,所以加载下该模块:
modprobebr_netfilter
创建/etc/sysctl.d/k8s.conf文件,添加如下内容:
net.bridge.bridge-nf-call-ip6tables=1
net.bridge.bridge-nf-call-iptables=1
net.ipv4.ip_forward=1
bridge-nf
bridge-nf 使得 netfilter 可以对 Linux 网桥上的 IPv4/ARP/IPv6 包过滤。比如,设置net.bridge.bridge-nf-call-iptables=1后,二层的网桥在转发包时也会被 iptables的 FORWARD 规则所过滤。常用的选项包括:
net.bridge.bridge-nf-call-arptables:是否在 arptables 的 FORWARD 中过滤网桥的 ARP 包
net.bridge.bridge-nf-call-ip6tables:是否在 ip6tables 链中过滤 IPv6 包
net.bridge.bridge-nf-call-iptables:是否在 iptables 链中过滤 IPv4 包
net.bridge.bridge-nf-filter-vlan-tagged:是否在 iptables/arptables 中过滤打了 vlan 标签的包。
执行如下命令使修改生效:
sysctl-p/etc/sysctl.d/k8s.conf
安装 ipvs:
$ cat > /etc/sysconfig/modules/ipvs.modules <<EOF
#!/bin/bash
modprobe -- ip_vs
modprobe -- ip_vs_rr
modprobe -- ip_vs_wrr
modprobe -- ip_vs_sh
modprobe -- nf_conntrack_ipv4
EOF
$ chmod 755 /etc/sysconfig/modules/ipvs.modules && bash /etc/sysconfig/modules/ipvs.modules && lsmod | grep -e ip_vs -e nf_conntrack_ipv4
上面脚本创建了的/etc/sysconfig/modules/ipvs.modules文件,保证在节点重启后能自动加载所需模块。使用lsmod | grep -e ip_vs -e nf_conntrack_ipv4命令查看是否已经正确加载所需的内核模块。
接下来还需要确保各个节点上已经安装了 ipset 软件包:
yuminstallipset
为了便于查看 ipvs 的代理规则,最好安装一下管理工具 ipvsadm:
yuminstallipvsadm
同步服务器时间
$ yum install chrony -y
$ systemctl enable chronyd
$ systemctl start chronyd
$ chronyc sources
210 Number of sources = 4
MS Name/IP address         Stratum Poll Reach LastRx Last sample
===============================================================================
^+ sv1.ggsrv.de                  2   6    17    32   -823us[-1128us] +/-   98ms
^- montreal.ca.logiplex.net      2   6    17    32    -17ms[  -17ms] +/-  179ms
^- ntp6.flashdance.cx            2   6    17    32    -32ms[  -32ms] +/-  161ms
^* 119.28.183.184                2   6    33    32   +661us[ +357us] +/-   38ms
$ date
Tue Aug 27 09:28:41 CST 2019
关闭 swap 分区:
swapoff-a
修改/etc/fstab文件,注释掉 SWAP 的自动挂载,使用free -m确认 swap 已经关闭。swappiness 参数调整,修改/etc/sysctl.d/k8s.conf添加下面一行:
vm.swappiness=0
执行sysctl -p /etc/sysctl.d/k8s.conf使修改生效。
到这里为止上面所有的操作都需要在所有节点执行配置。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 12
 0
- 0


 已为社区贡献18条内容

所有评论(0)