一种融合遗传算法和机器学习的混合方法
前言
这种设计使得优化过程能够动态地考虑到不同分配决策对拣选员状态(学习与疲劳)的影响,解决考虑拣选者因疲劳的订单拣选批次分配问题,从而做出更智能、更符合实际的决策。
研究背景与问题
-
订单拣选是仓库运营中最耗时、成本最高的环节之一。
-
现有研究多关注优化行走距离,而忽略了拣选员个体差异(如学习能力和疲劳)对拣选时间的影响。
-
缺乏同时考虑批次特征(如数量、空间分布)与拣选员学习、疲劳因素的集成方法
研究目标
-
开发一种集成方法,能够同时考虑批次特征和拣选员学习与疲劳,优化批次分配。
-
比较非线性机器学习模型与线性模型在预测拣选时间方面的优势。
-
评估考虑学习与疲劳的分配策略相较于忽略这些因素的策略的有效性。
方法框架
提出一个三模块混合方法:
-
特征工程模块:
-
计算批次的数量与空间特征(如总重量、体积、行走距离、不同区域数量等)。
-
计算拣选员的学习指标(历史累积)和疲劳指标(当日累积)。
-
-
预测模块:
-
使用CatBoost(一种非线性梯度提升模型。是俄罗斯的搜索巨头Yandex在2017年开源的机器学习库,是Boosting族算法的一种。)预测拣选时间。
-
输入包括批次特征、学习与疲劳指标。
-
-
优化模块:
-
使用遗传算法(GA) 进行批次分配优化。
-
目标是最小化总拣选时间,并满足拣选员工作时间限制。
-
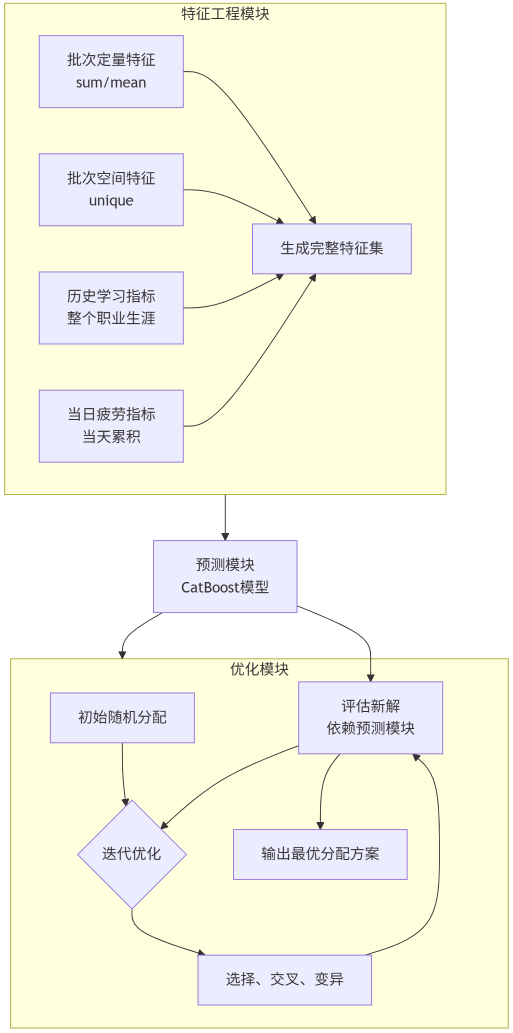
本文章核心研究方法是一个三阶段的混合建模框架,巧妙地将数据驱动预测与优化算法相结合。其核心流程如下图所示:
第一阶段:特征工程模块
此模块负责为预测模型构建输入特征。
-
批次定量特征:
-
总和:一个批次中所有商品的总重量、总体积、总数量、总行走距离。
-
均值:一个批次中所有商品的平均重量、平均体积、平均数量、平均行走距离。
-
-
批次空间特征:
-
唯一值计数:为完成一个批次需要访问的不同区域、不同货道、不同拣选位、不同层级的数量。这反映了任务的复杂性。
-
-
拣选员人为因素指标:
-
学习指标:基于拣选员整个职业生涯的历史累积值(例如,职业生涯累计拣选总重量、累计访问的不同位置总数)。这代表了其长期经验和技能。
-
疲劳指标:基于拣选员当前工作日的累积值(例如,当天已拣选的总重量、当天已访问的不同位置总数)。这代表了其当班的实时疲劳度。
-
第二阶段:预测模块(机器学习)
-
模型选择:采用 CatBoost 梯度提升决策树模型。
-
选择理由:
-
处理非线性关系:能够捕捉批次特征、学习、疲劳与拣选时间之间复杂的、非线性的相互作用。
-
处理表格数据能力强:在结构化数据(如本研究的仓库数据)上表现优异。
-
具备可解释性:优于其他“黑箱”模型(如神经网络),便于后续使用SHAP进行分析。
-
-
-
模型训练与作用:
-
使用历史数据训练模型,学习从输入特征到实际拣选时间的映射函数
H。 -
在优化过程中,该模型作为一个“代理模型”,能够快速评估任何候选分配方案下预测的总拣选时间。
-
第三阶段:优化模块(遗传算法)
-
算法选择:采用遗传算法 作为优化引擎。
-
选择理由:
-
能够有效处理目标函数为非线性(即ML预测模型)的优化问题。
-
在求解组合优化问题(如任务分配)方面有良好记录和灵活性。
-
-
-
关键设计:
-
编码方式:一个解(个体)是一个整数向量,长度等于批次数量,每个位置的值代表执行该批次的拣选员编号。
-
适应度函数:为候选分配方案预测的总拣选时间(越小越好)。
-
非可行解处理函数:衡量候选分配方案违反拣选员最大工作时间的程度(越小越好,为零时是可行解)。
-
种群更新:采用锦标赛选择、单点交叉和交换变异来生成新解,并通过局部改进策略增强可行性。
-
三模块的协同工作流程
该方法的核心创新在于三个模块的闭环交互,如上图所示。优化模块(GA)在探索不同的分配方案时,会反复调用特征工程模块和预测模块。对于每一个被GA评估的候选分配方案,特征工程模块会动态计算出该方案对应的学习与疲劳指标,然后预测模块基于这些新指标快速预测出该方案下的拣选时间,并反馈给GA进行优劣评估。这个过程不断迭代,最终引导GA找到最优的分配方案。
通过融合机器学习(用于精准预测)和遗传算法(用于优化分配),可以构建一个既高效又人性化的订单分配系统。该系统不仅能更准确地预估作业时间,更重要的是能制定出更符合拣选员实际工作状态、可行性更高的工作计划。
1. 非线性机器学习模型(CatBoost)能更准确地预测拣选时间
-
在预测订单批次的拣选时间时,使用CatBoost模型显著优于线性回归模型,平均绝对误差(MAE)降低了43%。
-
即使与其他先进的非线性模型(如XGBoost和MLP)相比,CatBoost也表现出最佳的预测精度,尽管其训练时间更长。
2. 同时考虑批次特征与人为因素(学习与疲劳)至关重要
-
特征消融实验证明:将拣选员的学习和疲劳指标与批次的数量、空间特征一起使用,能最大程度地提升预测精度。与仅使用批次特征相比,MAE降低了21.5%。
-
这证实了忽略人为因素会导致对拣选时间的估计不准确。
3. 考虑学习与疲劳的分配策略能显著提高方案的可行性
-
与忽略学习与疲劳的基准策略相比,本文提出的分配策略能极大降低不可行解的比例(从95%降至24%)。这意味着新策略分配的工作量更可能在实际操作中被拣选员完成,避免了超时工作。
-
在总拣选时间(Fitness) 上,两种策略没有统计上的显著差异。这表明新策略的主要优势在于生成更实际、更可靠的工作计划。
4. 模型可解释性分析(SHAP)揭示了复杂的影响关系
-
批次特征(如需要访问的拣选位置数量、平均商品体积)对拣选时间的影响最大。
-
学习效应总体上会缩短拣选时间,但某些指标(如历史累积行走距离)反而会增加时间,这可能与长期工作带来的潜在效率下降有关。
-
疲劳效应的影响比预期小,且某些情况下较高的疲劳值对应着更短的预测时间,这可能是因为轻微的疲劳反而会激发短期的效率提升,或者与指标的计算方式有关。
以下几个核心学术概念,它们代表了该研究在理论和方法上的关键创新点:
1. 人类因素与操作优化的融合
这是文章最核心的学术思想。它突破了传统运营管理研究中将人视为“恒定生产力单位”的假设,将行为科学(学习效应、疲劳效应)与工业工程/运筹学优化模型进行了系统性融合。这标志着从“以系统为中心”的优化向“以人为中心”的优化的范式转变,紧密契合了“工业5.0”的人本理念。
2. 预测性-规范性分析框架
文章构建了一个完整的 “预测-优化” 闭环框架:
-
预测性分析:使用机器学习模型来预测在特定情境下(特定批次、特定拣选员状态)的未来结果(拣选时间)。
-
规范性分析:使用优化算法(遗传算法)来规定应该采取的最佳行动(批次分配方案),以实现既定目标(总时间最短)。
这种方法将数据驱动的洞察力直接转化为可执行的决策,代表了运营管理领域的前沿方法论。
3. 非线性与异构性建模
-
非线性关系:文章明确否定了传统线性回归模型的假设,承认批次特征、学习、疲劳与拣选时间之间的关系是复杂的、非线性的。使用CatBoost这类机器学习模型的核心目的就是为了捕捉这种复杂性。
-
异构性:研究充分考虑了个体拣选员之间的差异(即异构性),而非使用一个“平均”的拣选员模型。优化模型为每个拣选员量身定制任务分配,这正是其优势所在。
4. 基于代理的仿真优化
在方法层面,研究构建了一个 “基于代理的优化” 系统:
-
机器学习模型作为一个“代理模型”:由于精确的数学函数
T_{ijs}是未知且复杂的,研究者训练了一个ML模型来充当这个函数的高精度代理。 -
优化器与代理交互:遗传算法(优化器)不断生成候选解决方案,并通过查询这个代理模型来评估其质量,从而引导搜索方向。这使得在无法获得解析表达式的情况下,依然能对复杂系统进行优化。
5. 动态累积状态变量
对学习和疲劳的量化方式是一个关键概念创新。它们没有被建模为简单的静态变量,而是被定义为动态累积的状态变量:
-
学习:是整个职业生涯历史的函数,是一个长期、缓慢变化的状态。
-
疲劳:是当日工作历史的函数,是一个短期、快速变化的状态。
-
这种定义使得模型能够捕捉到任务的序列依赖性——即一个批次分配的先后顺序会影响拣选员的状态,从而影响后续批次的执行效率。
6. 混合整数非线性规划问题
从数学规划的角度,研究所解决的问题可以被归类为一个 混合整数非线性规划 问题:
-
混合:决策变量
x_{ijs}是二元的(整数),而目标函数和约束涉及连续变量(时间、疲劳、学习指标)。 -
整数:分配决策是离散的。
-
非线性:目标函数
T_{ijs}是一个由机器学习模型表示的黑箱非线性函数。
这一概念定位解释了为什么研究者放弃精确的线性规划算法,而选择元启发式算法(如遗传算法)作为求解工具。
7. 模型可解释性
没有满足于机器学习模型的“黑箱”预测,而是进一步利用 SHAP 这一先进的可解释性AI技术来解读模型。这使得研究者能够:
-
验证理论预期(如学习效应通常降低时间)。
-
发现反直觉的洞察(如某些学习指标可能增加时间),并对此进行讨论。
-
量化不同特征对预测结果的影响程度,增强了研究的科学性和可信度。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 18
 0
- 0


 已为社区贡献1条内容

所有评论(0)