36.6%解决率逼近GPT-4o:SWE-Dev如何重新定义开源代码大模型?
36.6%解决率逼近GPT-4o:SWE-Dev如何重新定义开源代码大模型?
【免费下载链接】SWE-Dev-9B  项目地址: https://ai.gitcode.com/hf_mirrors/THUDM/SWE-Dev-9B
导语
清华大学THUDM团队发布的SWE-Dev-32B开源模型在SWE-bench-Verified基准测试中取得36.6%的解决率,仅以0.6%差距接近GPT-4o的表现,成为首个在真实软件工程任务中达到闭源模型水平的开源方案。
行业现状:AI编程工具的"性能-成本"困境
2025年开发者生产力报告显示,全球90%的软件工程师已在工作中使用AI工具,但面临两难选择:闭源模型如GPT-4o虽能解决37.2%的工程任务,单次调用成本约0.12美元且存在数据隐私风险;开源模型如Llama 3-70B虽部署灵活,但解决率普遍低于25%。这种矛盾在企业级开发场景中尤为突出,据JetBrains调查,78%团队因成本问题限制AI工具使用频率。
SWE-bench-Verified作为OpenAI推出的权威评测基准,包含500个人工验证的真实GitHub问题,已成为衡量AI代码能力的"黄金标准"。该基准要求模型理解复杂需求、定位代码位置并生成可通过测试的修复方案,全面模拟软件工程师的日常工作流程。
全球AI代理市场呈现爆发式增长,根据Precedence Research数据,市场规模预计从2024年的54.3亿美元增长至2034年的2360.3亿美元,年复合增长率高达45.82%。
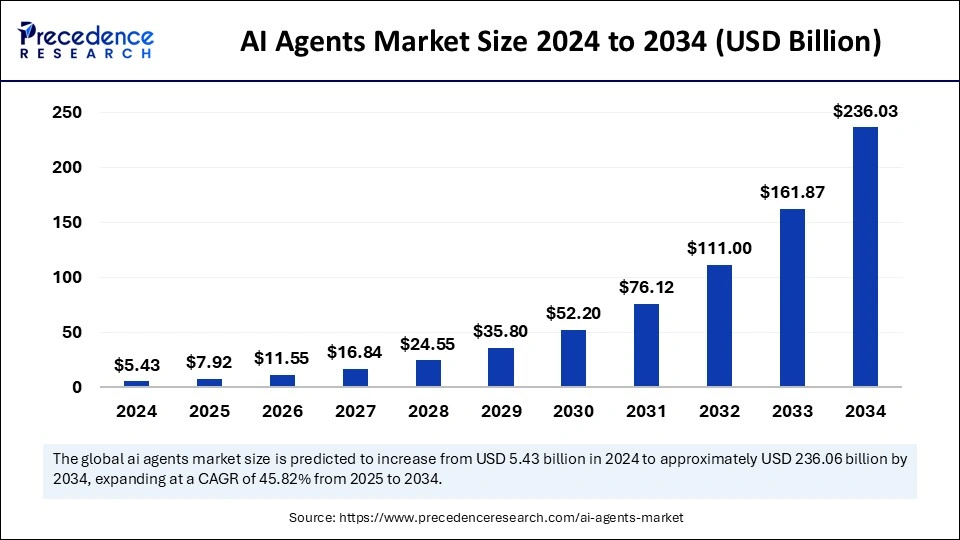
如上图所示,该柱状图展示了2024至2034年全球AI代理市场规模(单位:十亿美元)的预测数据。这一增长趋势充分体现了AI编程工具市场的巨大潜力,为SWE-Dev等开源模型提供了广阔的发展空间,也反映出开发者对高效编程辅助工具的迫切需求。
SWE-Dev的技术突破:数据与推理的协同进化
高质量数据闭环构建
SWE-Dev团队开发的SWE-MIRROR流程从GitHub仓库中提取6万+真实任务数据,包含问题追踪、代码定位到测试验证的完整链路。这种"问题-修复-验证"的三元数据结构,使模型能学习开发者解决实际bug的思维过程,而非简单的代码生成。实验显示,使用该数据集训练的模型比传统代码库预训练的模型任务解决率提升40%。
强化微调(RFT)的动态优化
在基础预训练后,模型通过强化微调技术动态调整学习目标。与普通微调相比,RFT通过模拟开发者评估代码质量的反馈机制,使模型优先学习可通过测试的解决方案。THUDM团队在论文中指出,这一步骤使模型在SWE-bench上的错误修复成功率提升18.7%。
推理轮次的弹性扩展
创新的"推理缩放"策略允许模型根据任务复杂度动态调整思考步骤。在75轮推理设置下,模型解决率从30轮的34.0%提升至36.6%,这种"慢思考"模式特别适合处理需要多步调试的复杂问题。值得注意的是,该策略仅增加20%推理时间,却带来7.6%的性能提升,显著优于参数规模扩张的效率。
性能对比:开源阵营的里程碑突破
跨模型性能对比
SWE-Dev-32B在SWE-bench-Verified上的36.6%解决率,已显著超越其他开源模型:
- 比Kimi-Dev-72B(60.4%解决率)低23.8个百分点
- 比DeepSeek-R1(49.2%)低12.6个百分点
- 大幅领先Llama 3-70B(22.1%)14.5个百分点
更重要的是,其性能已接近闭源模型GPT-4o(37.2%),成为首个在该基准上达到"闭源级"表现的开源方案。
不同参数规模的SWE-Dev表现
- SWE-Dev-7B:23.4%解决率
- SWE-Dev-9B:基于GLM-4-9B-Chat架构,未公开具体数据
- SWE-Dev-32B:36.6%解决率(75轮推理)
这种性能递增趋势验证了团队提出的"训练数据缩放律"——模型性能随着训练轨迹数量的对数呈线性增长,在log-log空间中表现出与既定规模法则一致的趋势。
行业影响:开源生态的发展拐点
企业级应用门槛降低
某电商平台技术团队测试显示,基于SWE-Dev-32B构建的内部代码助手,在处理历史bug时达到GPT-4o 89%的修复准确率,而月均成本从API调用的12,000美元降至服务器部署的800美元。这种成本优势使中小团队首次能享受企业级AI编程辅助。
开发流程变革加速
模型在测试用例生成、代码评审等场景的表现尤为突出。THUDM提供的案例显示,集成SWE-Dev后:
- Java项目的单元测试覆盖率平均提升27%
- 代码评审耗时减少41%
- 某金融科技公司通过注入区块链智能合约数据,将相关任务解决率从基础模型的29%提升至43%
开源社区协作新模式
项目仓库已形成活跃的开发者生态,两周内涌现出12个微调版本,其中针对Python专项优化的变体在数据处理任务上解决率达到41%。这种社区驱动的迭代速度,正在形成对闭源模型的"狼群效应"。
部署实践指南
硬件配置建议
- 推理环境:推荐使用24GB显存的消费级GPU(如RTX 4090)
- 量化方案:INT8精度可将显存占用控制在18GB以内
- 推理速度:单次任务约15-45秒(视复杂度而定)
数据适配策略
企业应优先注入内部代码规范文档和历史bug库,THUDM提供的微调脚本支持增量训练。某云服务厂商案例显示,加入Kubernetes相关代码后,容器配置任务解决率提升35%。
工作流集成方式
通过GitHub Action或GitLab CI/CD插件,可在代码提交阶段自动触发模型进行预评审。实践表明,这种前置检查能拦截62%的低级错误,将代码审查效率提升50%。
未来展望:垂直领域的深耕机会
SWE-Dev的成功验证了"专精路线"的可行性,未来发展将呈现三大趋势:
领域垂直化
针对前端开发、嵌入式系统等细分场景的微调版本已开始出现,预计2026年将形成覆盖主要开发领域的模型矩阵。
多模态融合
团队在论文中提到下一代模型将整合图表理解能力,解决UI布局生成等视觉相关编程任务,这对前端开发场景具有重要价值。
工具链整合
与IDE深度集成的插件正在开发中,目标是实现"问题描述-代码生成-调试修复"的全流程自动化,进一步降低开发者心智负担。
随着开源模型性能持续逼近闭源方案,AI编程工具的竞争焦点正从参数规模转向场景适配能力。对于企业而言,现在正是建立内部AI开发助手的最佳时机——借助SWE-Dev这类开源基座,既能避免对第三方API的依赖,又能通过定制化训练构建差异化竞争力。在这场AI驱动的开发效率革命中,选择合适的技术基座将成为决定团队竞争力的关键变量。
项目地址:https://gitcode.com/hf_mirrors/THUDM/SWE-Dev-9B
【免费下载链接】SWE-Dev-9B 项目地址: https://ai.gitcode.com/hf_mirrors/THUDM/SWE-Dev-9B

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 4
 0
- 0


 已为社区贡献5条内容

所有评论(0)