如何解决大模型的「幻觉」问题?
如何解决大模型的「幻觉」问题?
幻觉可以说早就已经是LLM老生常谈的问题了,那为什么会产生这个现象该如何解决这个问题呢?快来和我们分享一下吧~
> 提醒:在发布作品前,请把不需要的内容删掉。
方向一:什么是大模型「幻觉」
大模型的「幻觉」(Hallucination)指模型在缺乏知识或推理链断裂时,生成看似合理但实际错误的内容。它来自概率生成机制本身:模型会用语言模式去“补全”,不保证事实正确。
方向二:造成大模型「幻觉」的原因
提示:可以用自己所掌握的知识来解释为什么会有这样的现象
方向三:解决该问题的方法
| 方法 | 核心思想 | 优缺点 | 典型技术 |
| -------------------- | ------------ | ------------ | ----------------------------- |
| **高质量数据清洗** | 去除噪声、虚假数据 | 减少错误传播,但成本高 | 自动弱标注过滤 |
| **指令精调(SFT)** | 用正确示例教模型遵循事实 | 显著降低幻觉 | Alpaca, BELLE |
| **偏好对齐(RLHF / DPO)** | 用人类偏好惩罚错误答案 | 成本高需人工反馈 | ChatGPT alignment |
| **知识蒸馏** | 老师模型提供更准知识 | Teacher错=一起错 | Self-Consistency, Re-checking |
方向四:大模型技术的未来
| 方法 | 原理 | 特点 |
| ---------------------------------------- | ------------- | --------- |
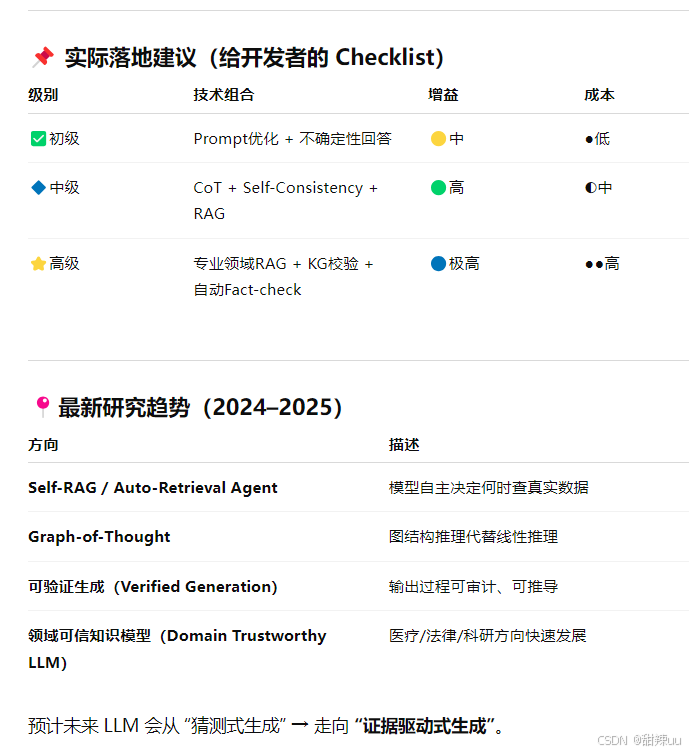
| ✅**RAG(Retrieval-Augmented Generation)** | 按需检索+引用事实生成答案 | 当前最主流、强效果 |
| 知识图谱(KG)融合 | 结构化知识校验事实一致性 | 适合专业领域 |
| 数据库/文档外接 | 模型只作为自然语言接口 | 减少臆测 |

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)