AI电话机器人接入大模型的实战指南:从零搭建到生产环境优化
快速体验
在开始今天关于 AI电话机器人接入大模型的实战指南:从零搭建到生产环境优化 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
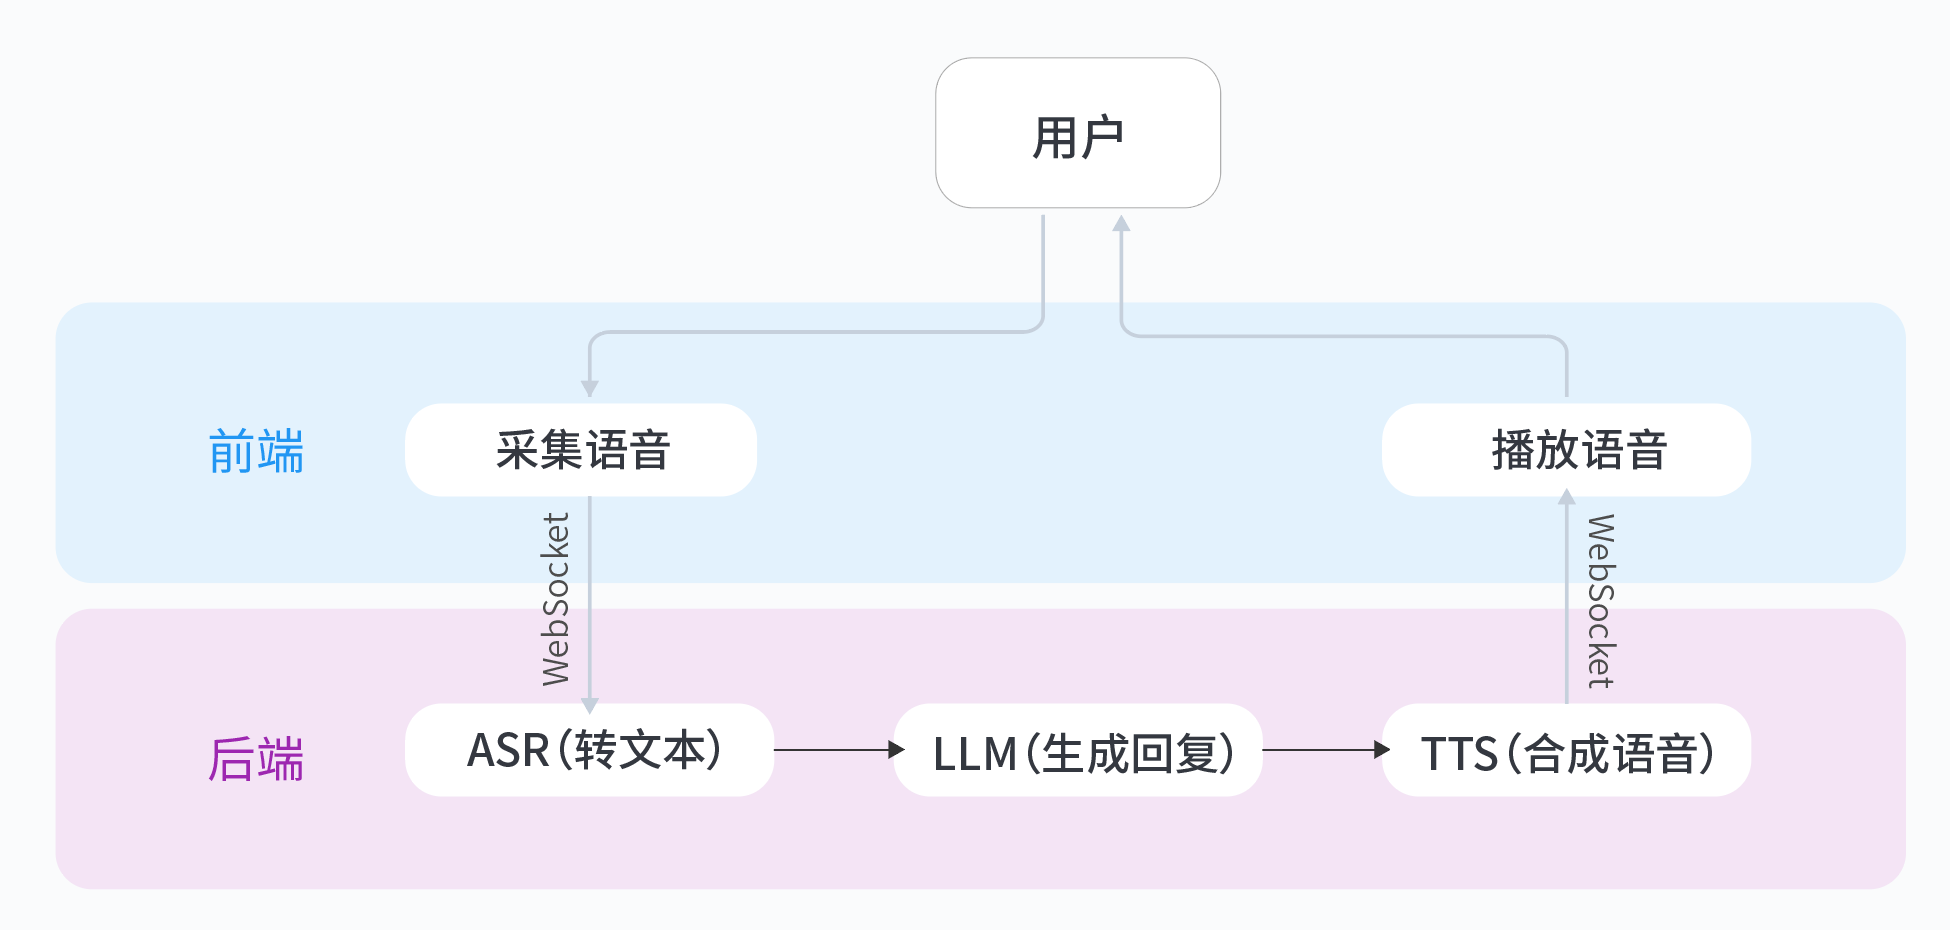
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI电话机器人接入大模型的实战指南:从零搭建到生产环境优化
背景痛点分析
传统IVR系统与AI电话机器人在技术实现上存在显著差异。传统IVR依赖于预设的菜单树和固定语音流程,而AI电话机器人需要处理开放域对话场景。接入大模型时主要面临三大挑战:
-
延迟敏感性问题
- 端到端延迟(E2E Latency)需控制在800ms以内才能保证自然对话体验
- 语音编解码、网络传输、模型推理等环节都会引入延迟
- 突发流量可能导致响应时间波动(Jitter Buffer设计尤为关键)
-
会话连贯性维护
- 多轮对话需要准确跟踪对话状态(Dialog State)
- 用户突然切换话题时需处理上下文断裂问题
- 语音识别错误可能导致对话逻辑混乱
-
资源消耗与稳定性
- 大模型API调用成本随并发量指数级增长
- 长时通话可能导致内存泄漏
- 网络抖动时需保证语音流持续传输
技术选型建议
主流大模型API对比分析:
| 特性 | OpenAI Whisper+GPT | Claude Instant | 国产大模型(如豆包) |
|---|---|---|---|
| 语音识别支持 | 需要额外ASR接入 | 不支持 | 原生支持 |
| 平均响应延迟 | 300-500ms | 700-900ms | 200-400ms |
| 多轮对话能力 | 优秀 | 良好 | 优秀 |
| 中文处理能力 | 良好 | 一般 | 优秀 |
| 成本(千次调用) | $1.2 | $0.8 | ¥5.0 |
推荐技术栈组合:
- 通信层:FastAPI + WebSocket (低延迟双向通信)
- 音频处理:FFmpeg + PyAudio (实时编解码)
- 会话管理:Redis + 状态机模式
- 部署架构:Kubernetes + HPA (自动扩缩容)
核心实现方案
音频流处理管道
-
编解码转换
使用FFmpeg处理G.711与PCM的实时转换:ffmpeg -f alsa -i default -acodec pcm_s16le -ar 16000 -ac 1 -f rtp rtp://127.0.0.1:5000 -
语音活动检测(VAD)
基于WebRTC的VAD算法实现静音检测:def vad_processor(audio_chunk): sample_rate = 16000 frame_duration = 30 # ms frame_size = int(sample_rate * frame_duration / 1000) aggressiveness = 2 return webrtcvad.Vad(aggressiveness).is_speech( audio_chunk, sample_rate, frame_size)
对话状态机设计
状态转移图关键节点:
[等待唤醒] -> [语音输入] -> [ASR处理]
    ↓                      ↑
[大模型推理] <- [对话管理]
    ↓
[TTS合成] -> [音频输出]
状态保持机制:
class DialogState:
    def __init__(self):
        self.history = []
        self.current_intent = None
        self.slot_values = {}

    def update(self, user_input):
        self.history.append(('user', user_input))
        if len(self.history) > 10:  # 上下文窗口控制
            self.history.pop(0)
安全与限流方案
-
输出限流
使用令牌桶算法控制大模型调用频率:from ratelimit import limits, sleep_and_retry @sleep_and_retry @limits(calls=30, period=60) def call_llm_api(prompt): # API调用实现 pass -
敏感词过滤
基于AC自动机的多模式匹配:from ahocorasick import Automaton filter = Automaton() for word in sensitive_words: filter.add_word(word, word) filter.make_automaton()
生产环境优化
压力测试方案
使用Locust模拟高并发场景:
from locust import HttpUser, task, between

class ChatbotUser(HttpUser):
    wait_time = between(0.5, 2)

    @task
    def test_conversation(self):
        self.client.post("/chat", json={
            "audio": base64_audio_chunk,
            "session_id": "test123"
        })
关键指标监控:
- 99分位响应时间 < 1s
- 错误率 < 0.5%
- 单节点RPS > 50
容错机制实现
-
语音中断补偿
采用双缓冲技术处理网络抖动:class JitterBuffer: def __init__(self, max_size=5): self.buffer = [] self.max_size = max_size def add_packet(self, packet): if len(self.buffer) < self.max_size: self.buffer.append(packet) def get_packet(self): return self.buffer.pop(0) if self.buffer else None -
模型热切换
基于配置中心的动态路由:def model_router(session_id): hash_key = hash(session_id) % 100 if hash_key < config['model_a_weight']: return ModelA else: return ModelB
典型问题解决方案
-
静音检测失效
- 现象:背景噪声导致VAD误判
- 解决方案:增加基于能量的二次校验
def energy_based_vad(audio, threshold=0.01): rms = np.sqrt(np.mean(np.square(audio))) return rms > threshold -
上下文丢失
- 现象:长时间停顿后对话逻辑断裂
- 解决方案:实现会话超时续期机制
def renew_session(session_id, ttl=300): redis_client.expire(f"session:{session_id}", ttl) -
并发冲突
- 现象:同一session并行处理导致状态混乱
- 解决方案:使用Redis分布式锁
with redis_client.lock(f"lock:{session_id}", timeout=5):
    # 关键区操作
    pass
延伸思考方向
情感识别的智能降噪实现路径:
- 基于声纹特征的情绪分类模型
- 结合语音内容的情感分析(文本+语调)
- 动态调整降噪强度:
- 兴奋状态:保留更多高频成分
- 平静状态:增强低频清晰度
- 端到端方案:
graph LR
A[原始音频] --> B[情感识别]
B --> C{情绪类型}
C -->|兴奋| D[轻度降噪]
C -->|平静| E[深度降噪]
想亲自体验大模型与语音技术的结合?推荐尝试从0打造个人豆包实时通话AI动手实验,该实验提供了完整的代码示例和云端开发环境,30分钟即可搭建出可运行的对话系统原型。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐



 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)