大数据分布式集群
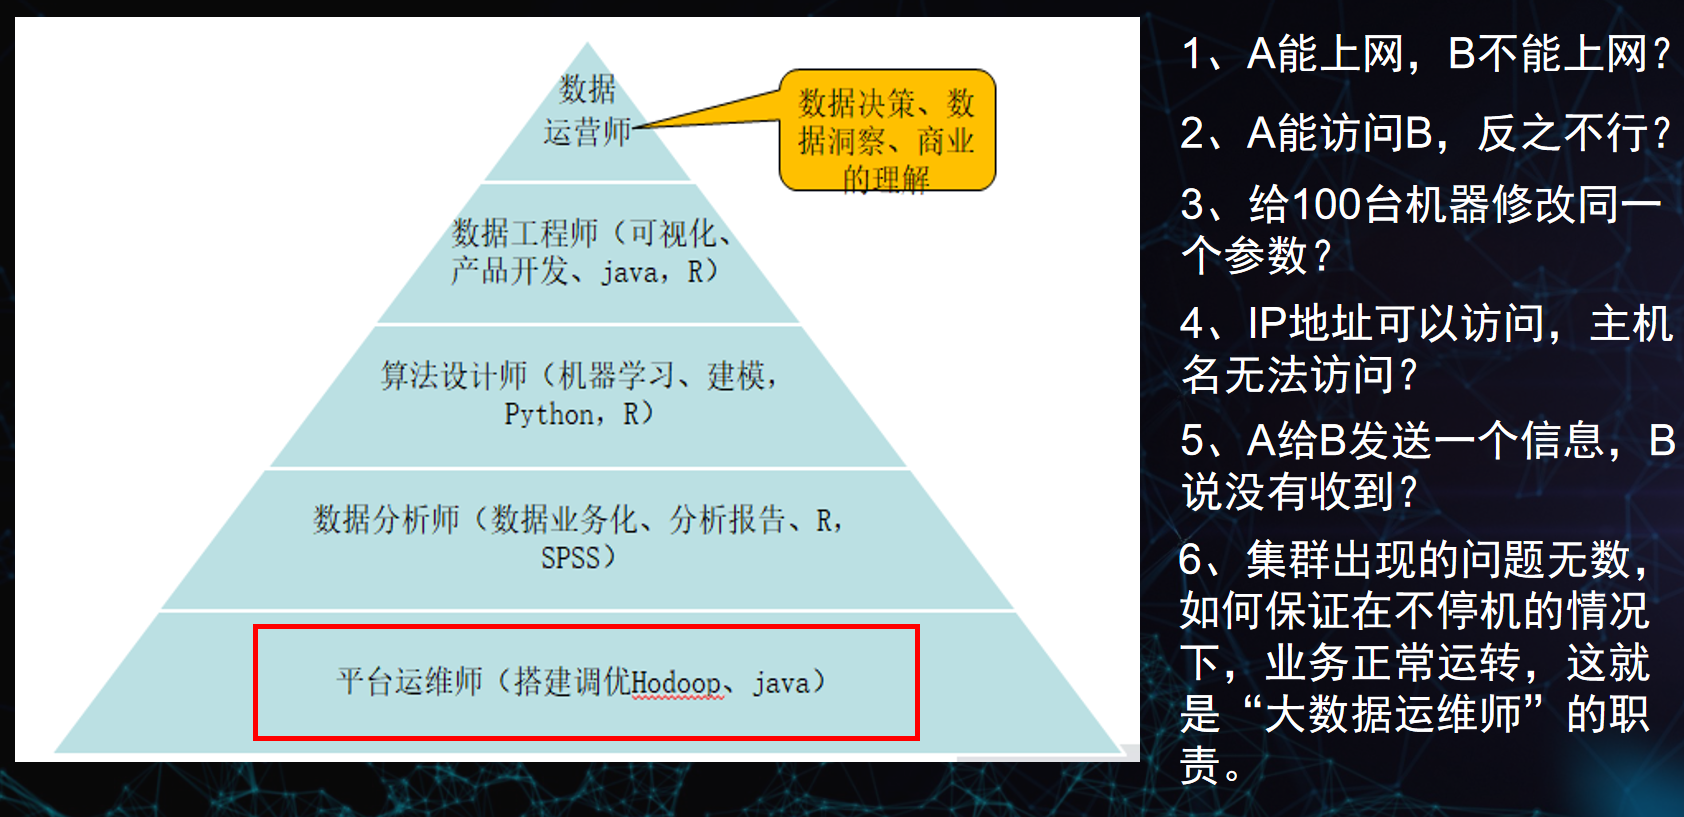
通过这张图清晰展示了大数据领域的岗位层级金字塔,并明确了大数据运维师的核心定位:
一、岗位层级(从底层到顶层)
1. 平台运维师(底层基石):负责搭建、调优Hadoop等大数据集群,保障集群稳定、高可用运行,是所有上层数据工作的基础支撑。
2. 数据分析师:基于业务做数据化分析,输出分析报告,常用工具R、SPSS。
3. 算法设计师:负责机器学习建模,用Python、R等语言实现算法,支撑智能化业务。
4. 数据工程师:负责数据可视化、产品开发,掌握Java、R等开发技能。
5. 数据运营师(顶层):基于数据做决策、洞察商业逻辑,驱动业务增长。
二、大数据运维师的核心职责
右侧列举的集群问题(网络连通性、批量配置、服务高可用等),正是运维师的核心工作:在不停机的前提下,保障大数据集群稳定、高效、安全运转,为所有上层数据岗位提供可靠的底层平台支撑。
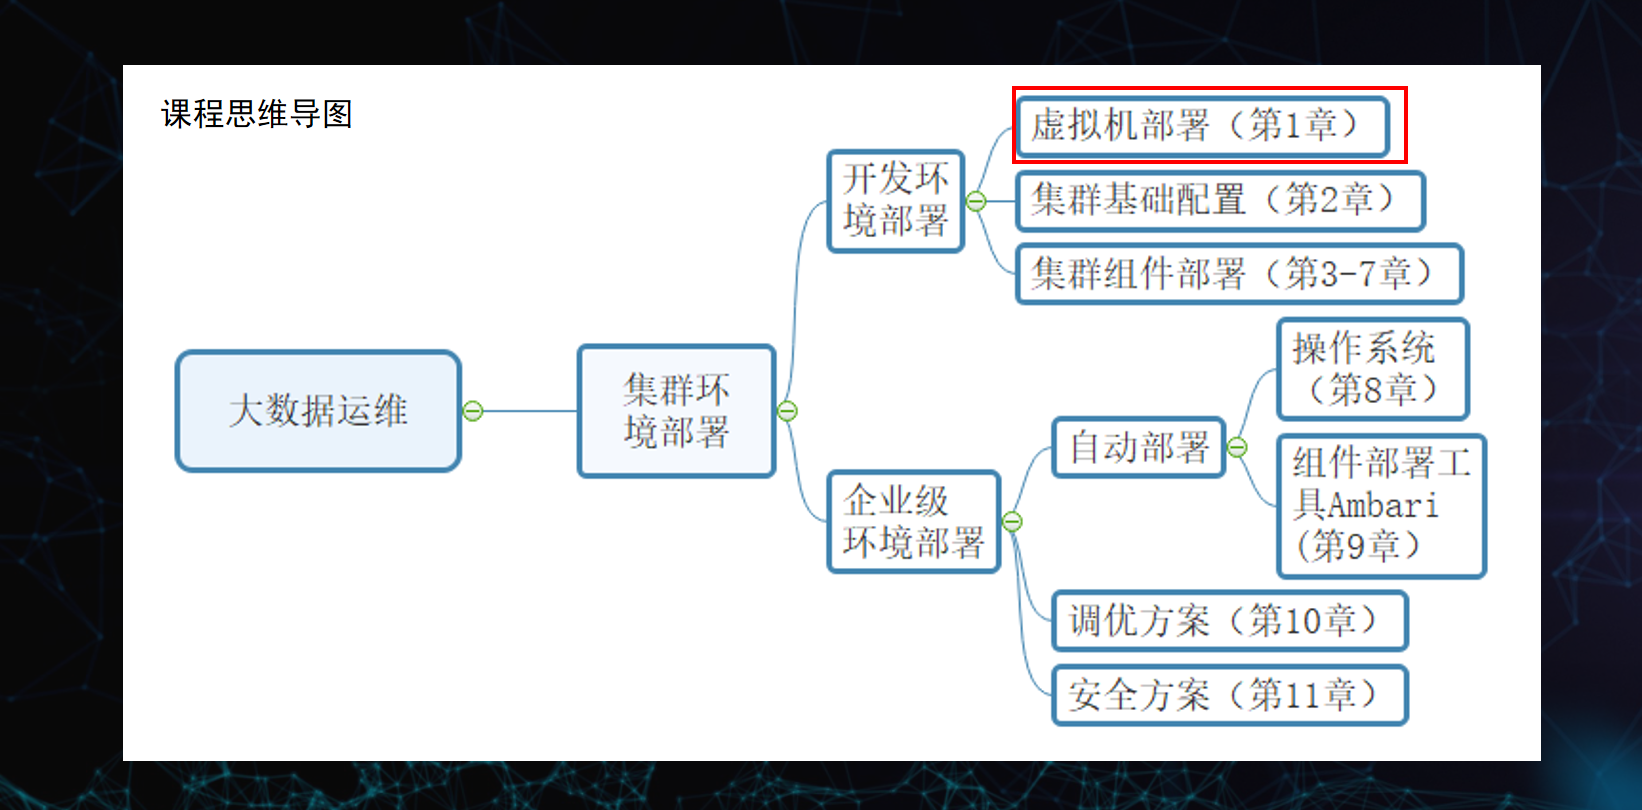
根据这张思维导图清晰梳理了大数据运维课程的完整学习路径,整体分为两大核心模块:
一、开发环境部署(入门基础)
从零基础搭建学习环境,循序渐进:
1. 第1章:虚拟机部署:搭建学习用的基础虚拟环境
2. 第2章:集群基础配置:完成集群的网络、环境等基础准备
3. 第3-7章:集群组件部署:手动部署Hadoop等核心大数据组件
二、企业级环境部署(进阶实战)
对标企业生产环境,覆盖运维全流程:
1. 自动部署:学习操作系统配置、Ambari自动化部署工具(第8-9章)
2. 调优方案(第10章):掌握集群性能优化,提升运行效率
3. 安全方案(第11章):学习集群安全防护,保障数据与服务稳定
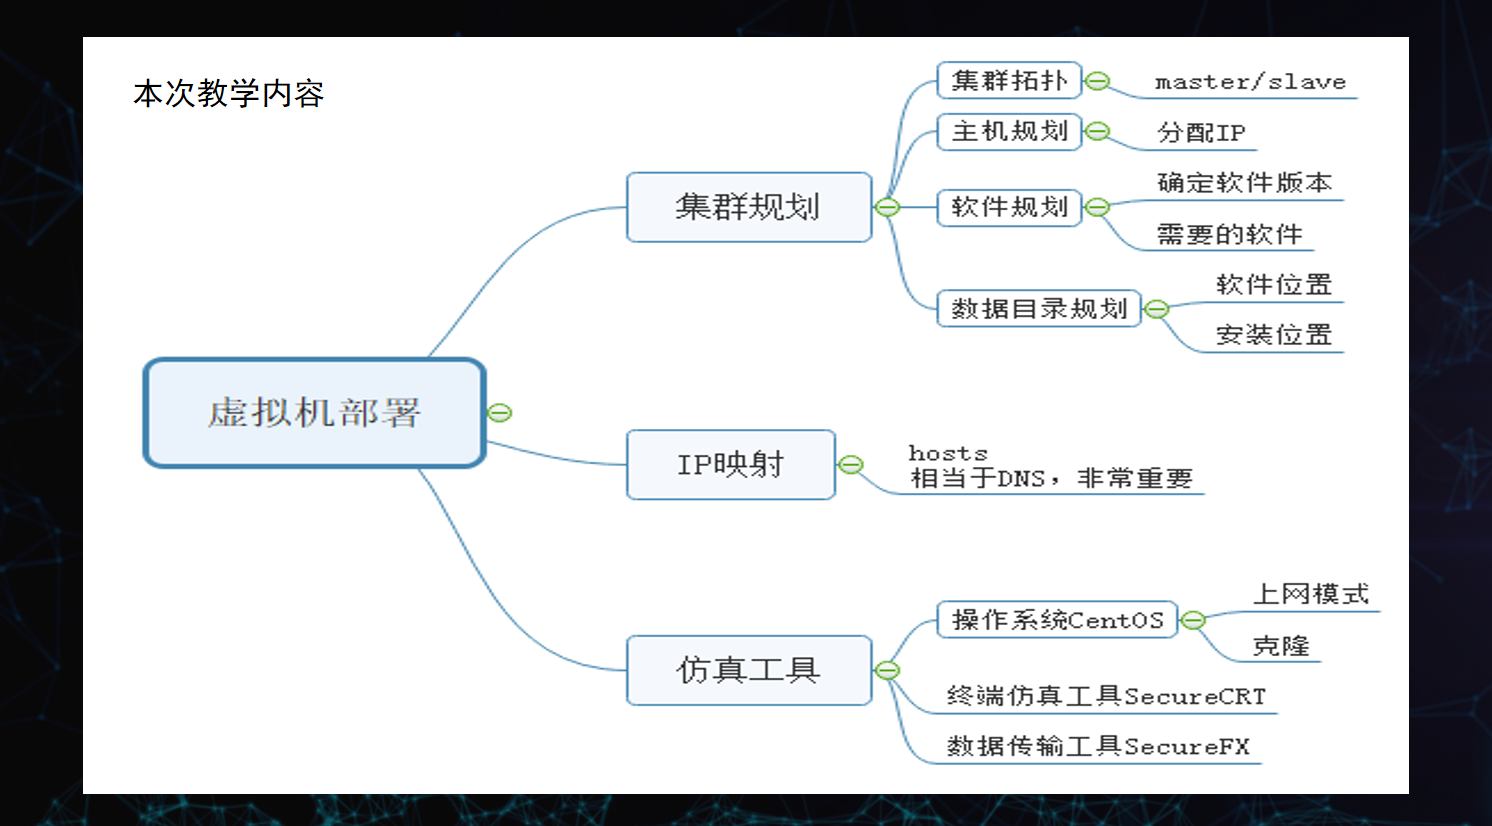
我们通过这张思维导图清晰拆解了虚拟机部署的完整教学内容,分为三大核心模块:
1. 集群规划(部署前置准备)
- 集群拓扑:确定master/slave主从架构
- 主机规划:为节点分配IP地址
- 软件规划:确定软件版本、梳理所需软件
- 数据目录规划:规划软件与数据的安装、存储位置
2. IP映射(集群通信核心)
通过配置 hosts 文件实现IP与主机名的映射,相当于集群内部的简易DNS,是保障节点间正常通信的关键步骤。
3. 仿真工具(环境搭建工具链)
- 操作系统:CentOS,配置上网模式、虚拟机克隆
- 终端工具:SecureCRT,用于远程连接操作
- 传输工具:SecureFX,用于文件数据传输
整个流程从前期规划到核心配置再到工具准备,完整覆盖了大数据集群虚拟机部署的全流程,是搭建大数据环境的基础入门内容。
Hadoop 是 Apache 基金会开发的分布式系统基础架构,是大数据领域的核心底层技术。
它以 HDFS(Hadoop分布式文件系统) 和 MapReduce 为两大核心:
- HDFS 负责海量数据的分布式存储,解决了大数据的存储问题;
- MapReduce 负责分布式并行计算,实现了对海量数据的高效处理。
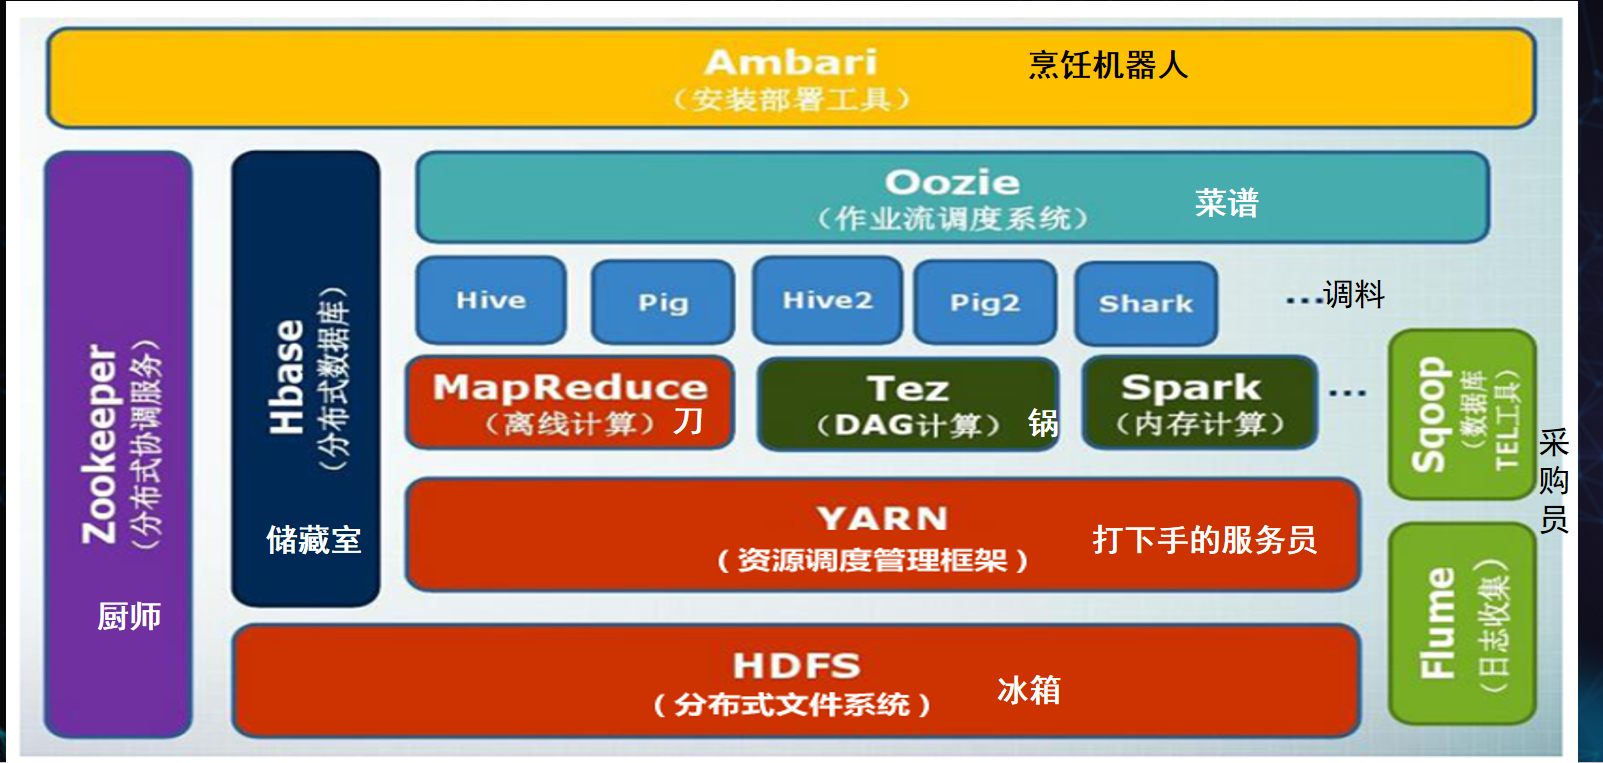
一、底层存储与协调(厨房基础)
- HDFS(冰箱):分布式文件系统,海量数据的永久存储仓库
- HBase(储藏室):分布式数据库,用于快速存取结构化数据
- Zookeeper(厨师):分布式协调服务,统一调度、监控全流程
二、算力与资源调度(烹饪工具)
- YARN(服务员):资源调度框架,分配算力、统筹任务执行
- MapReduce(刀):离线计算引擎,经典的大数据批处理工具
- Tez(锅):DAG计算引擎,优化多步任务、提升处理效率
- Spark(智能锅):内存计算引擎,高速处理实时/迭代任务
三、数据处理与采集(备餐环节)
- Hive/Pig/Shark(调料):数据处理工具,提供类SQL等易用接口
- Sqoop(采购员):数据库同步工具,实现外部数据导入
- Flume(收集员):日志采集工具,实时收集流式数据
四、调度与运维(厨房管理)
- Oozie(菜谱):作业流调度系统,自动化编排任务流程
- Ambari(烹饪机器人):部署运维工具,一键管理集群全生命周期
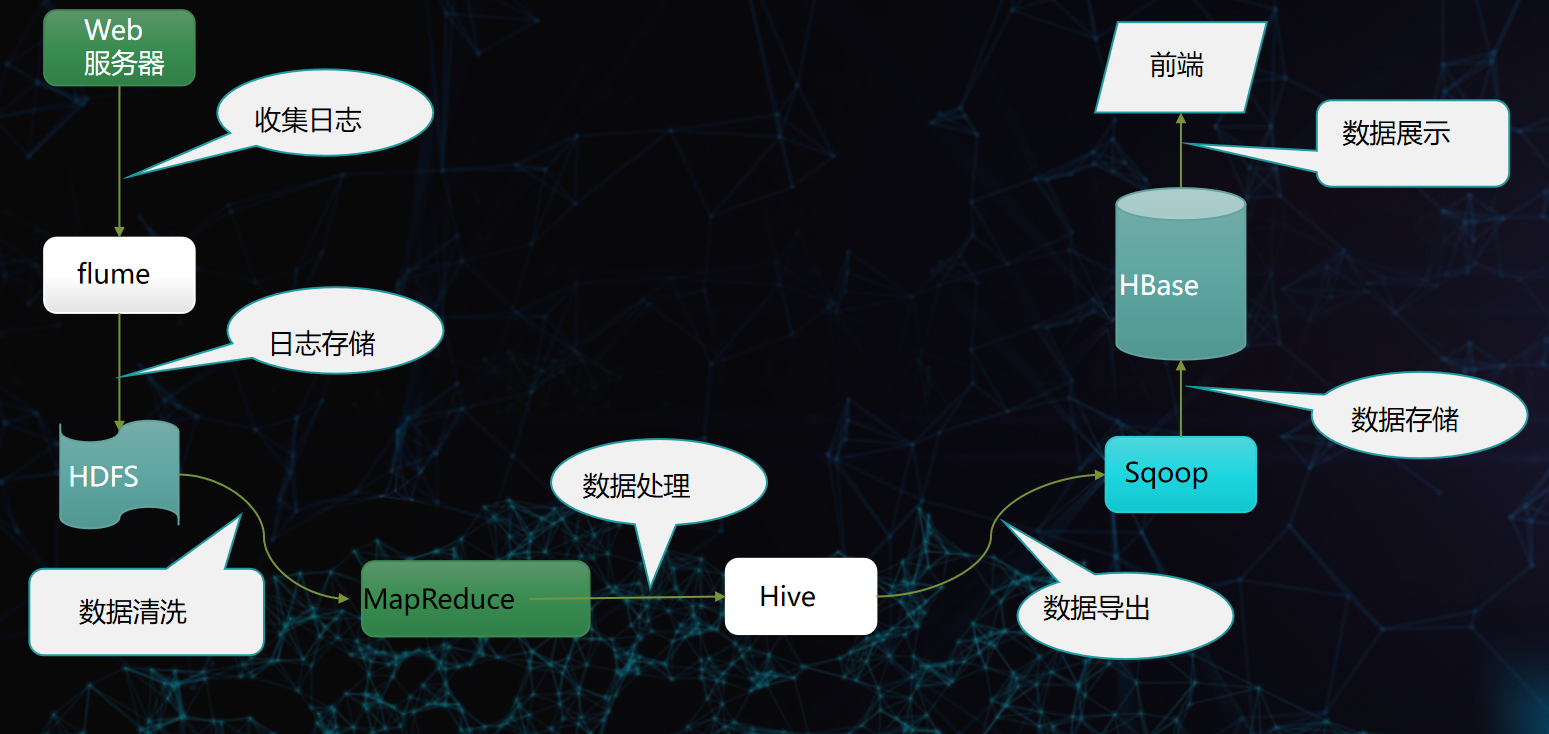
这张图展示了一套完整的大数据处理流程,核心是数据采集→存储→计算→导出→展示的闭环,对应到实际业务中就是从收集日志到呈现结果的全流程。
1. 数据采集与存储(源头入库)
- Web服务器 + Flume:Web服务器产生运行日志,由Flume实时收集,完成数据采集。
- HDFS:收集的日志直接存入HDFS(分布式文件系统),作为原始数据的长期存储载体。
2. 数据处理与分析(核心计算)
- 数据清洗 + MapReduce:对HDFS中的原始日志进行数据清洗,去除无效信息,再通过MapReduce(离线计算引擎)完成分布式处理。
- Hive:基于清洗后的数据,通过Hive(类SQL查询工具)进行分析统计,提取业务所需的有效数据。
3. 数据导出与应用(最终呈现)
- Sqoop:将Hive分析好的结果数据,通过Sqoop导出至HBase(分布式数据库),完成数据落地。
- 前端:最终从HBase中调取数据,在前端界面进行展示(如报表、可视化图表),供业务人员查看。
整个流程实现了“日志收集→存储处理→分析导出→可视化展示”的完整大数据应用闭环。

码道开发者社区,聚焦华为云码道 CodeArts 代码智能体,沉淀 Agent、Skill、鸿蒙开发实战内容,供开发者查阅资料、交流技术、分享工程实践
更多推荐


 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)